告别手工转换格式:办公文档四件套怎么用
本篇涵盖的知识重点
- 办公文档四件套的内置指令是 PDF、DOCX、PPTX、XLSX 四类
- PDF 能力覆盖抽取正文、抽取表格、OCR、拆分合并与表单处理
- DOCX 能力覆盖生成文档、整理结构、补目录、补页码、处理批注与修订
- PPTX 能力覆盖读取现有幻灯片、总结每页内容、压缩结构与重做演示文稿
- XLSX 能力覆盖清洗表格、补公式、整理列与输出汇总结果
- 遇到什么文件就用什么 Skill,并提前说清想要的输出结果
上手路径
四类文件能力详解
作用办公场景里真正耗时的往往不是写提示词,而是处理不同格式的文件,选错工具会白跑一趟。
操作拿到文件先判断后缀名:PDF 用 pdf,Word 用 docx,演示文稿用 pptx,表格用 xlsx。直接把文件路径和想要的结果告诉 WorkBuddy 即可。
注意遇到什么文件就用什么 Skill,这是最稳妥的方式;不要试图让一个 Skill 通吃所有格式。
- pdf:抽正文、抽表格、OCR、拆分合并、表单处理,扫描件也能进得来。
- docx:生成文档、整理结构、补目录、补页码、处理批注与修订,正式文档尤其适用。
- pptx:读取现有幻灯片、总结每页内容、压缩结构、重做演示文稿。
- xlsx:清洗表格、补公式、整理列、输出汇总结果,适合数据整理类任务。
- 从 PDF 中抽取正文、表格或做 OCR:直接把 PDF 路径交给 pdf。
- 生成或修改正式 Word 文档:用 docx,连目录和页码一起处理。
- 读取、压缩或重做 PPT:用 pptx,老演示文稿可以先瘦身。
- 清洗 Excel 数据并补公式、做汇总:用 xlsx,脏数据先过一遍。
作用扫描件和版式复杂的 PDF 无法直接复制,需要先做抽取或识别才能进入后续处理。
操作传入 PDF 路径,说明要抽取正文、抽取表格、做 OCR、拆分合并还是处理表单。例如让它把第 3 页到第 8 页拆出来,并把里面的表格导出成 Excel。
注意扫描件必须走 OCR,识别准确率取决于原件清晰度;涉及页码时要确认原文的页码编号方式。
作用正式文档对结构、目录、页码和批注有要求,靠手工调整非常费时。
操作说明是要生成新文档、整理结构、补目录、补页码,还是处理批注与修订。可以把已有草稿交给它,让它整理成可直接提交的正式版本。
注意明确是否保留原文的批注与修订痕迹;若需要留痕,提前说明不要接受全部修订。
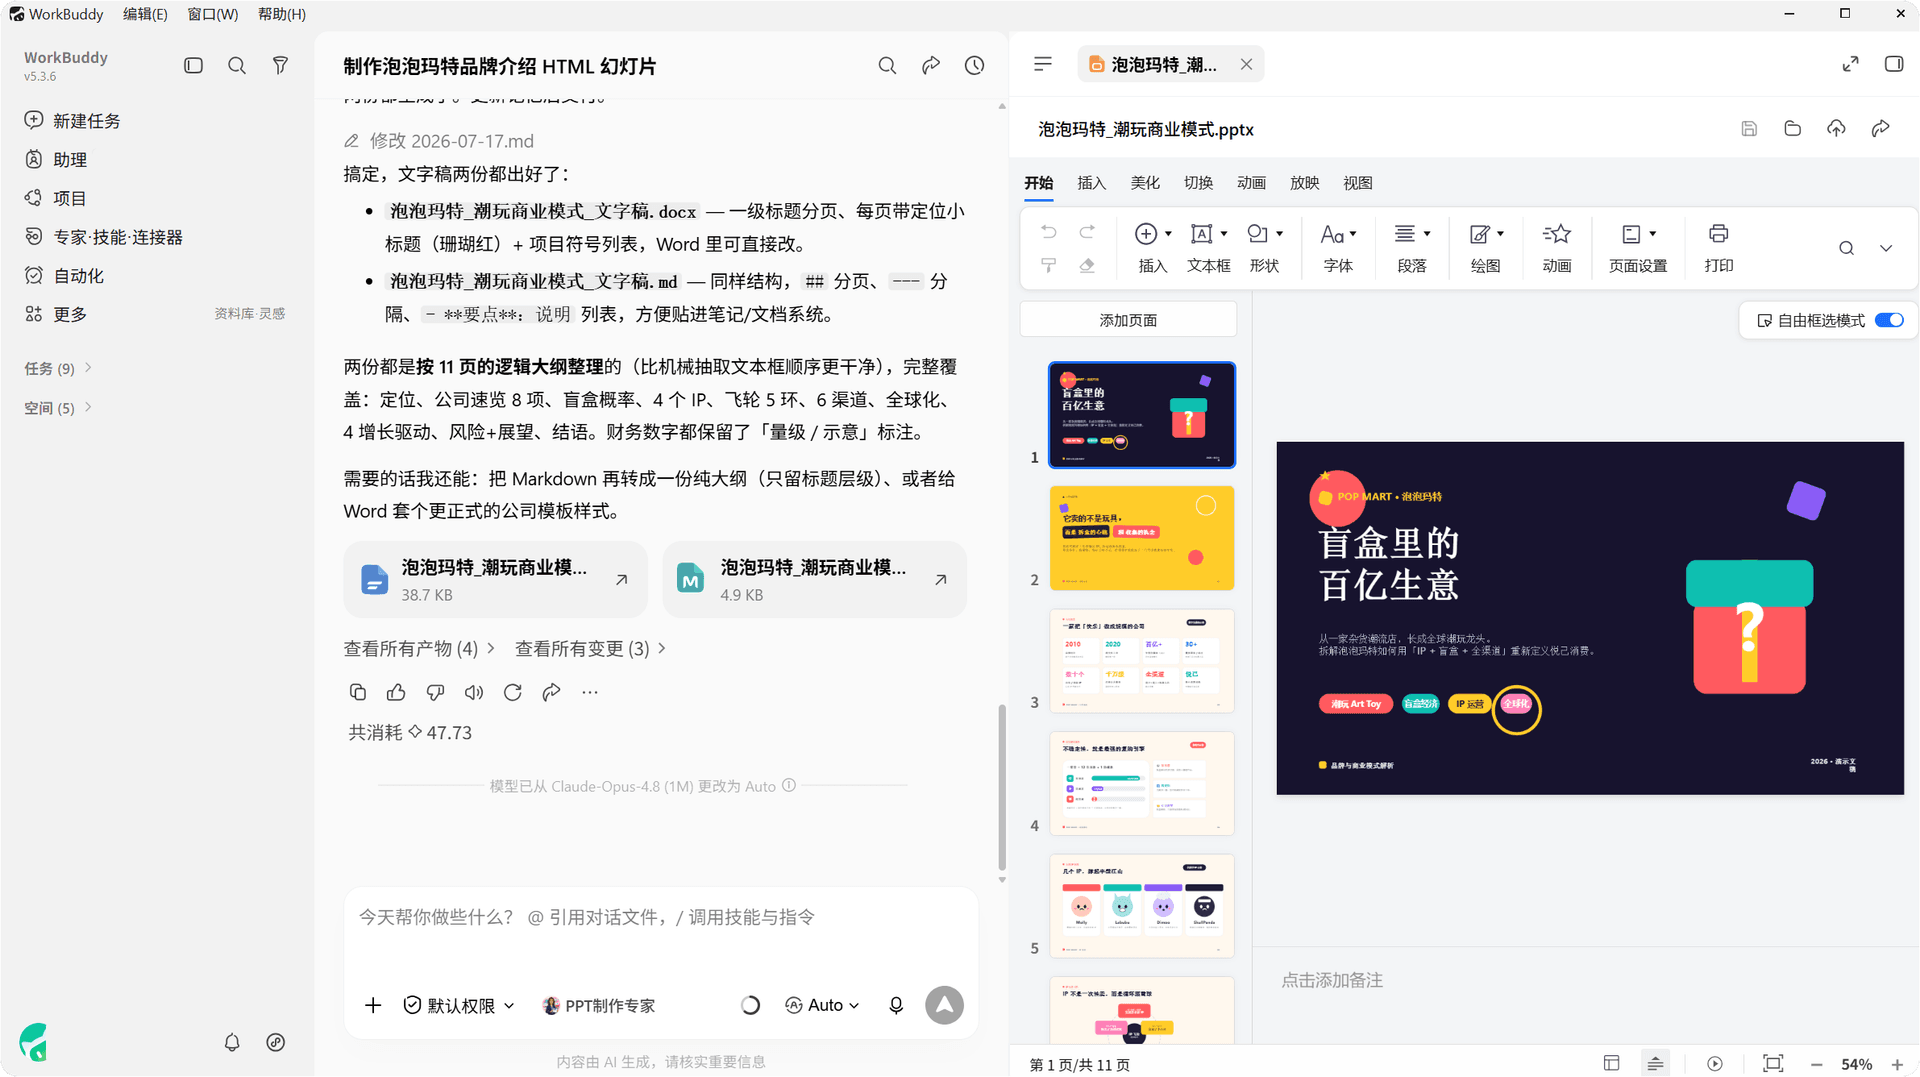
作用老旧演示文稿通常需要先瘦身或重做,才能直接进入汇报环节。
操作对 PPT 可要求读取现有幻灯片、总结每页内容、压缩结构或重做演示文稿。可以先让它逐页总结,再决定哪些页该合并、哪些页该重做。
注意压缩结构会改变原有页数;如果只是要换视觉风格,记得说明保留原分页。
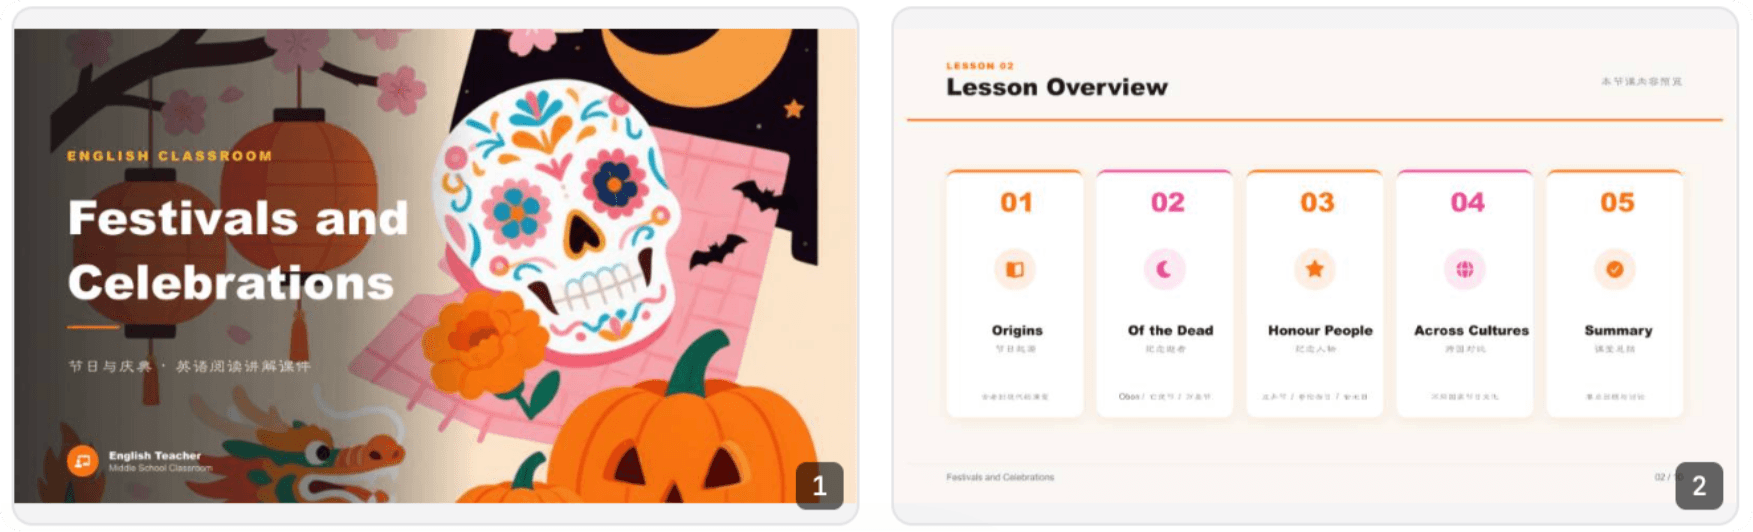
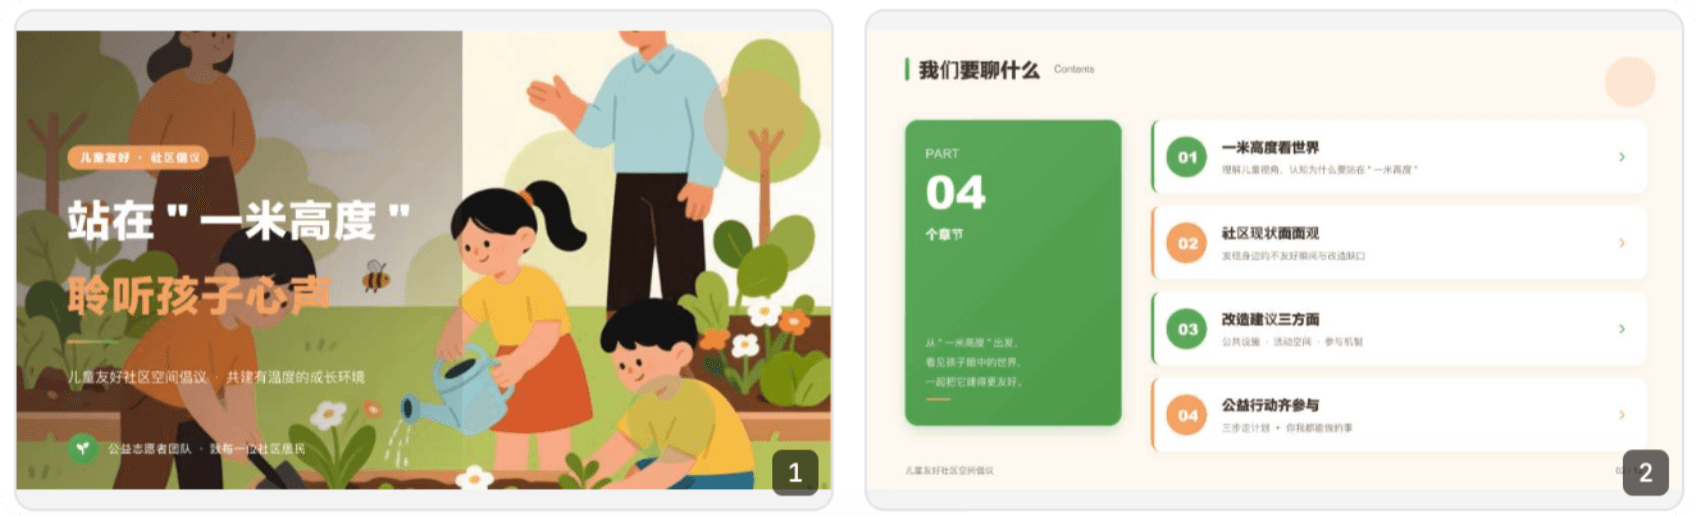
作用脏数据直接进统计,结果一定不可信,清洗是把表格交给 AI 前最值得做的一步。
操作对 Excel 可要求清洗表格、补公式、整理列、输出汇总结果。把原始文件路径和统计目标一起给出。
注意统计类任务要先说明字段含义与筛选口径;优先处理原始文件,可减少手动格式转换带来的损耗。
使用建议
- 遇到什么文件,就用对应 Skill:这是最稳妥的使用方式。
- 明确输出结果:例如提取文本、生成新文件、补充公式或改版结构。
- 优先处理原始文件:可减少手动格式转换带来的损耗。
要点练习
```markdown
我有一份扫描版 PDF,路径是 D:/资料/合同扫描件.pdf,里面的文字无法直接复制。请对它做 OCR 识别,把识别出的正文保存为一个 .txt 文件,放在原目录下,命名为「合同扫描件-OCR.txt」。完成后告诉我识别出的总字数,以及是否有明显识别不清的段落。
```原目录下出现 OCR 后的文本文件,并收到字数统计与识别质量说明;识别不清的段落应被明确指出。
```markdown
请处理这个 Word 文档:D:/方案/投标方案草稿.docx。需求有三项:1)按现有标题层级生成目录,放在正文之前;2)在页脚添加页码;3)整理正文结构,让同一级别的标题样式保持一致。处理前请先复制一份备份,备份文件名加后缀「_备份」。
```文档开头出现自动目录、页脚有页码、标题层级统一;同时目录下存在备份文件可供回退。
```markdown
请处理这个表格:D:/数据/销售明细.xlsx。任务:1)清洗数据,删除完全空白的行,统一「日期」列为 YYYY-MM-DD 格式;2)新增一列「金额」,公式为数量乘以单价;3)按「区域」汇总金额合计。输出一个新的 Excel 文件「销售明细-清洗后.xlsx」,并在对话里贴出区域汇总表。
```得到清洗后的新文件,空白行已清除、日期格式统一、金额列公式正确,并能在对话中看到按区域汇总的结果表。
本文基于官方文档再创作,具体以官方文档站实际展示为准。