代码生成率怎么算:企业研效度量看板使用指南
本篇涵盖的知识重点
- 研效度量入口为腾讯云代码助手管理端的数据统计 > 研效看板
- 看板分指标视图与趋势视图两种查看方式,历史数据需切换到旧看板
- 四类指标参数:活跃情况、对话指标、补全指标、代码生成指标
- 代码生成率(按行)= AI 生成代码行数 ÷ 总新增代码行数 × 100%
- 补全的「生成」与「采纳」是两回事,采纳需用户执行采纳操作才计入
- 复制或导入的代码超过 5 行不计入总新增,属于大幅度键入
- 成员明细与部门明细支持筛选,并可一键导出为 Excel 文件
- 研效度量数据同步需要 15 分钟,数据异常可等待后再确认
看板结构导览
指标口径与数据下钻
作用看板已全新升级,选对视图决定了你看到的是当期汇总还是变化趋势。
操作进入腾讯云代码助手管理端,选择 数据统计 > 研效看板。看板支持指标视图和趋势视图两种方式切换查看;若需要查看更新前的历史数据,需切换到旧看板。两类视图下都包含活跃情况、对话指标、补全指标、代码生成指标四类指标参数,每个指标都有详细的计算方式介绍。
注意升级后指标口径可能有变化,跨版本对比数据前先确认两段时间是否落在同一版看板口径内。
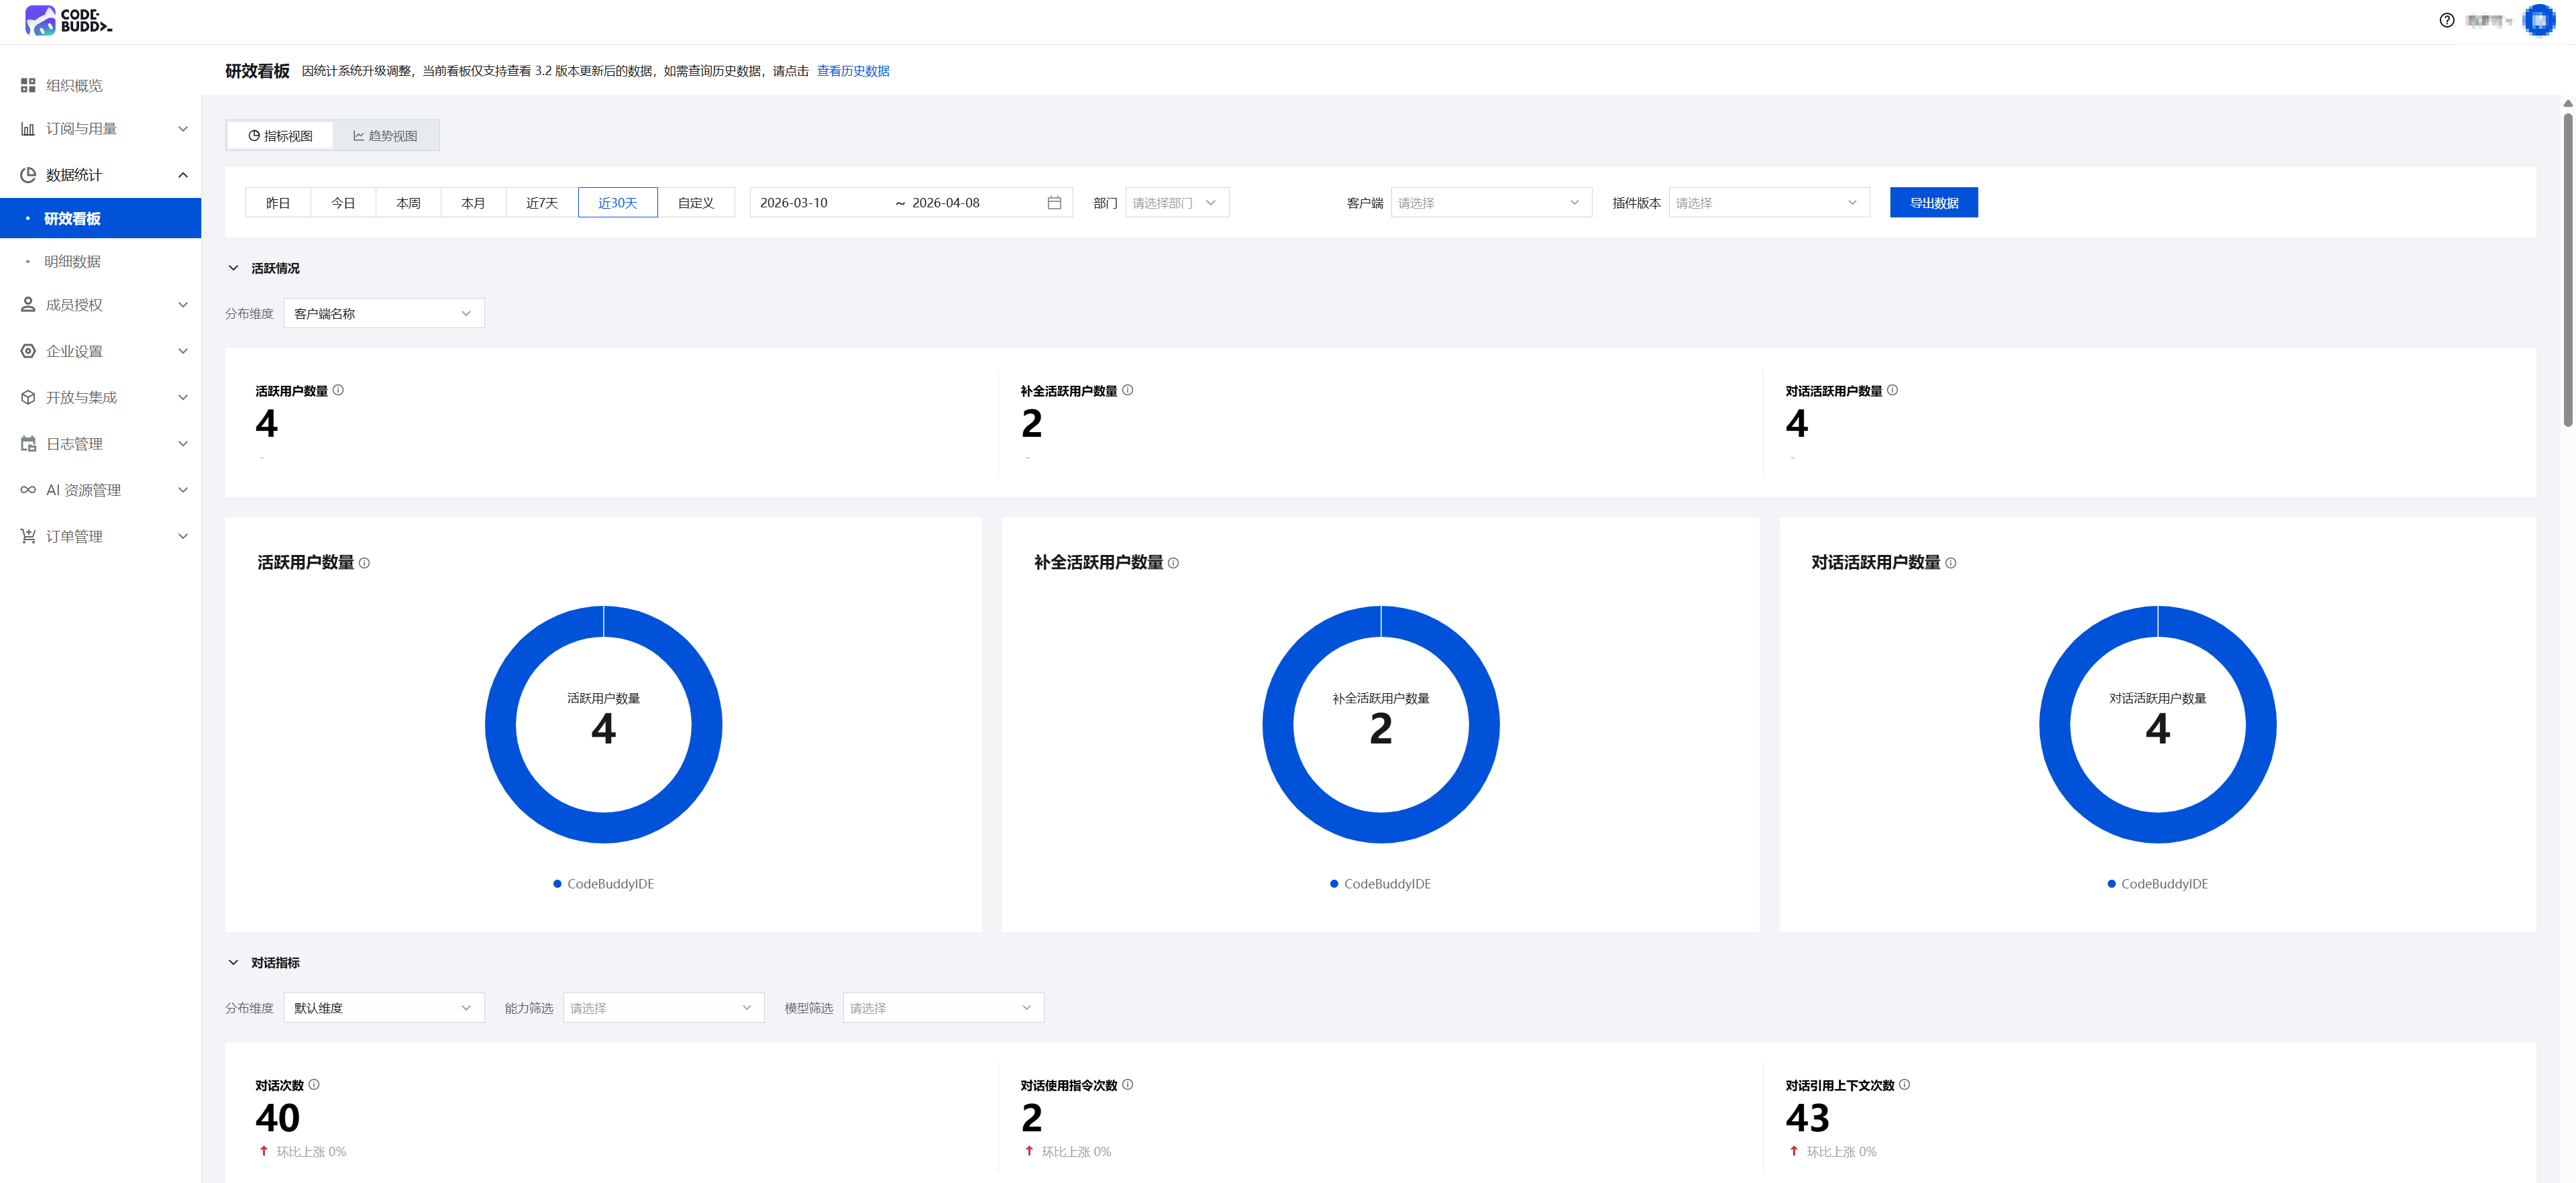

作用活跃数据回答「有多少人在用」,对话数据回答「用得多深」,是评估推广效果的第一步。
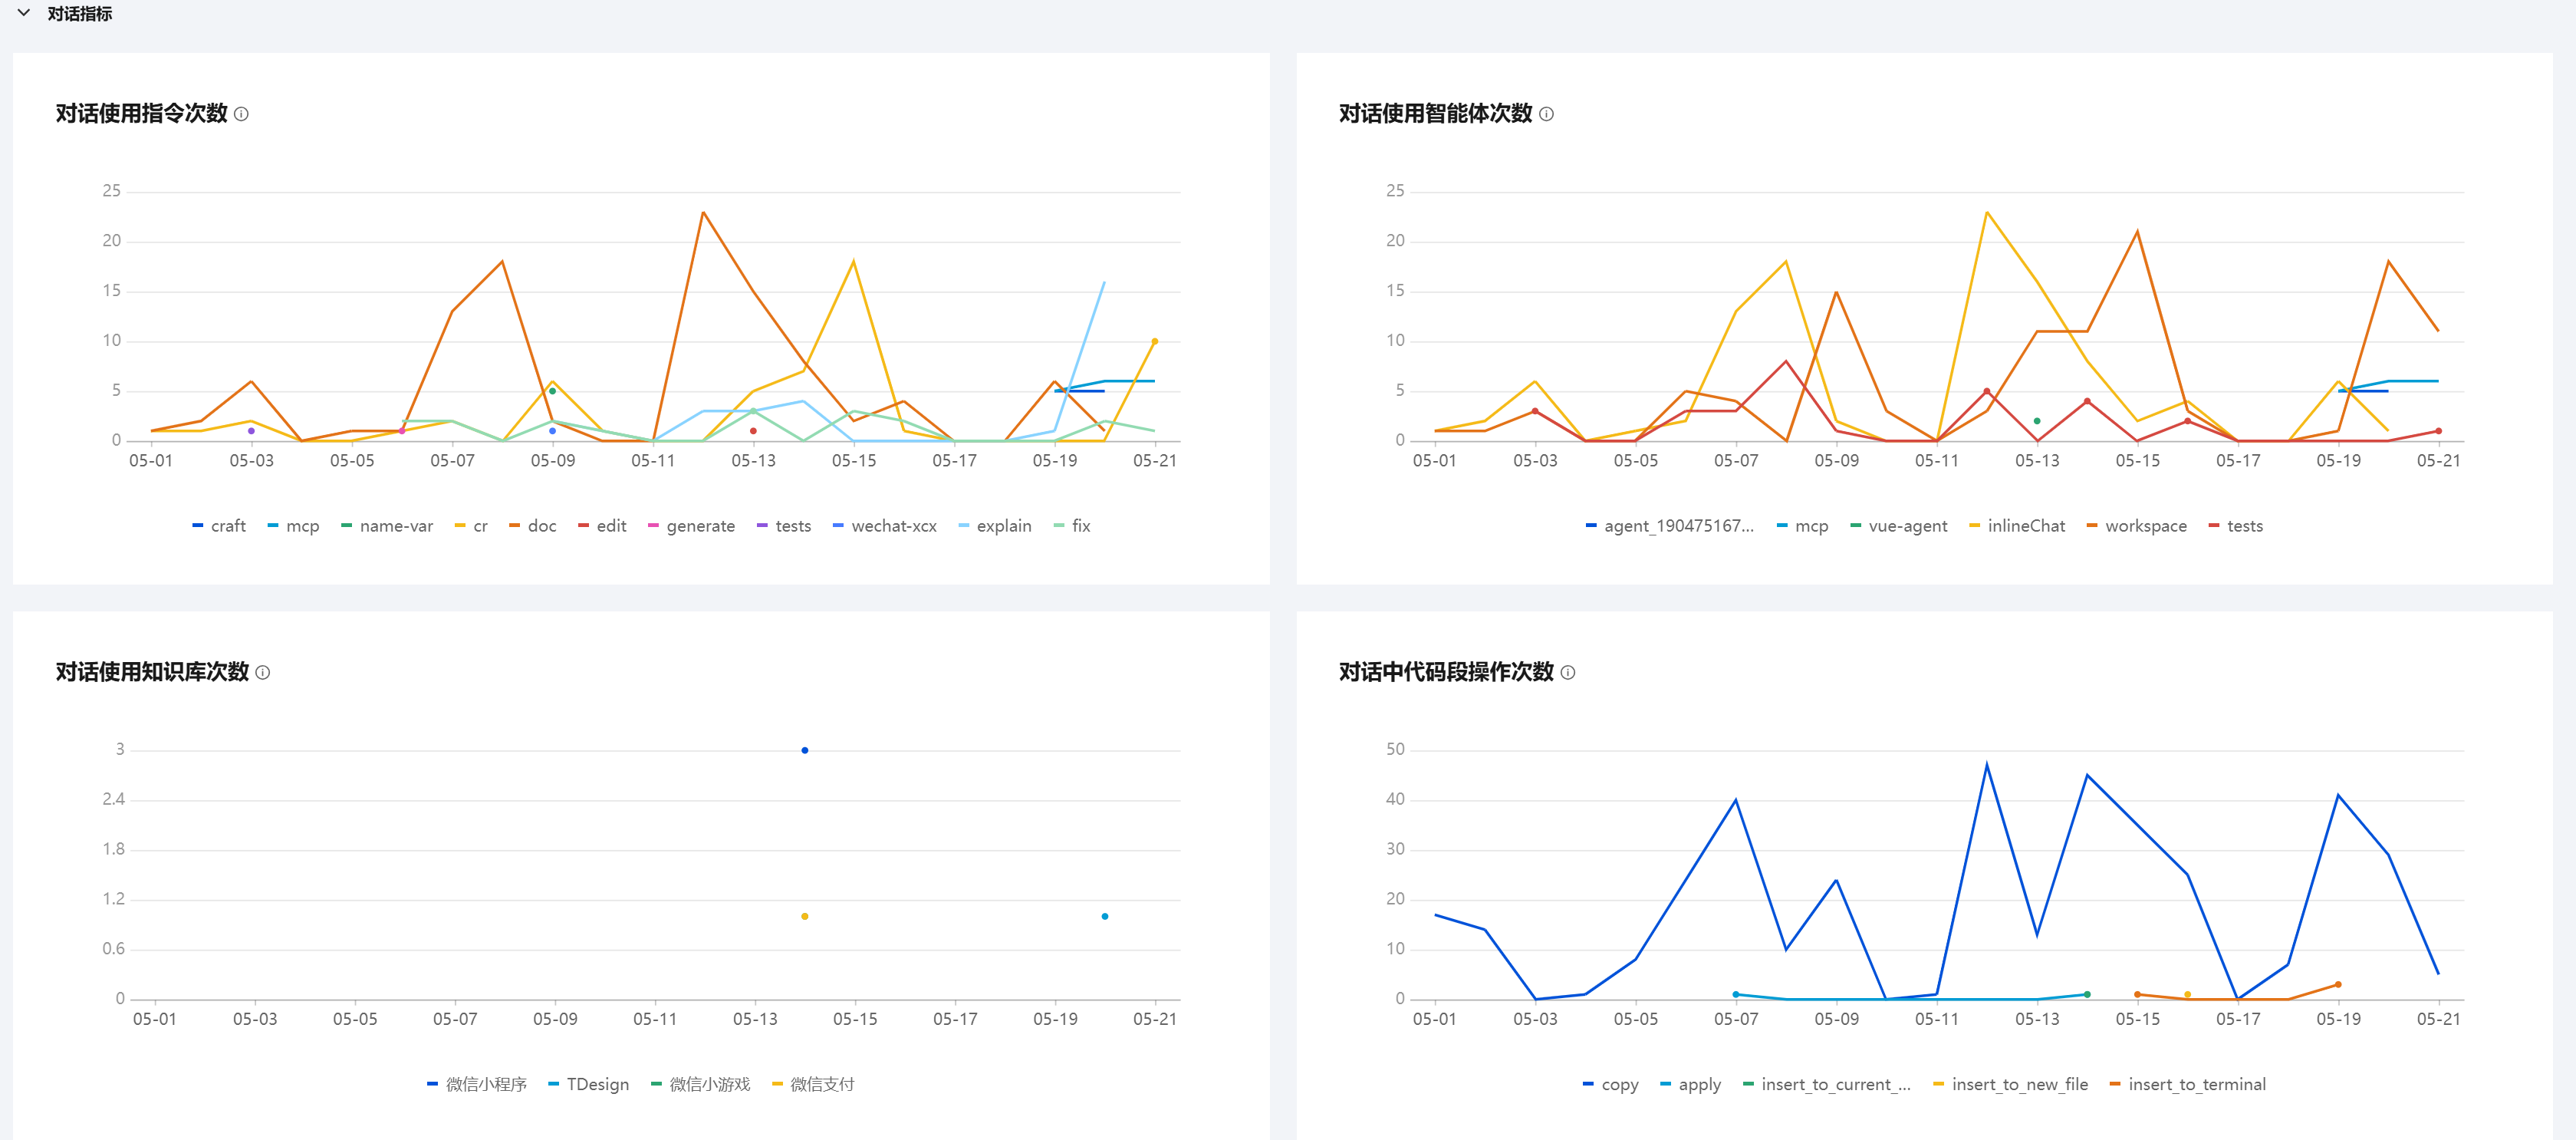
操作在活跃情况分类中查看活跃用户数量、补全活跃用户数量、对话活跃用户数量三个指标,并观察各 IDE 的活跃数量占比;在对话指标分类中查看对话次数、对话使用指令次数、对话引用上下文次数、对话使用智能体次数、对话使用知识库次数、对话中代码段操作次数六个指标。
注意对话引用上下文次数统计的是通过 @ 引用的次数,上下文明细类型包括文件、文件夹、Diff 文件、变更、知识库、终端命令等,不同团队的引用习惯会显著影响该数值。
- 活跃用户数量:统计周期内使用过补全或对话的用户数,看的是覆盖广度
- 补全活跃用户数量:使用过补全的用户数,可单独评估补全功能的渗透率
- 对话活跃用户数量:使用过对话的用户数,与上一条对比能看出团队的偏好
- 对话次数:使用对话的总次数,衡量使用强度
- 对话使用指令次数:对话时使用的斜杠命令次数,反映规范指令的使用习惯
- 对话引用上下文次数:对话时通过 @ 引用上下文的次数,上下文类型包括文件、文件夹、Diff 文件、变更、知识库、终端命令等
- 对话使用智能体次数:对话时使用的智能体次数,例如 @workspace
- 对话使用知识库次数:对话时使用的知识库次数,例如 #Vue
- 对话中代码段操作次数:对对话中返回的代码段执行的操作次数,体现代码被真正用了起来
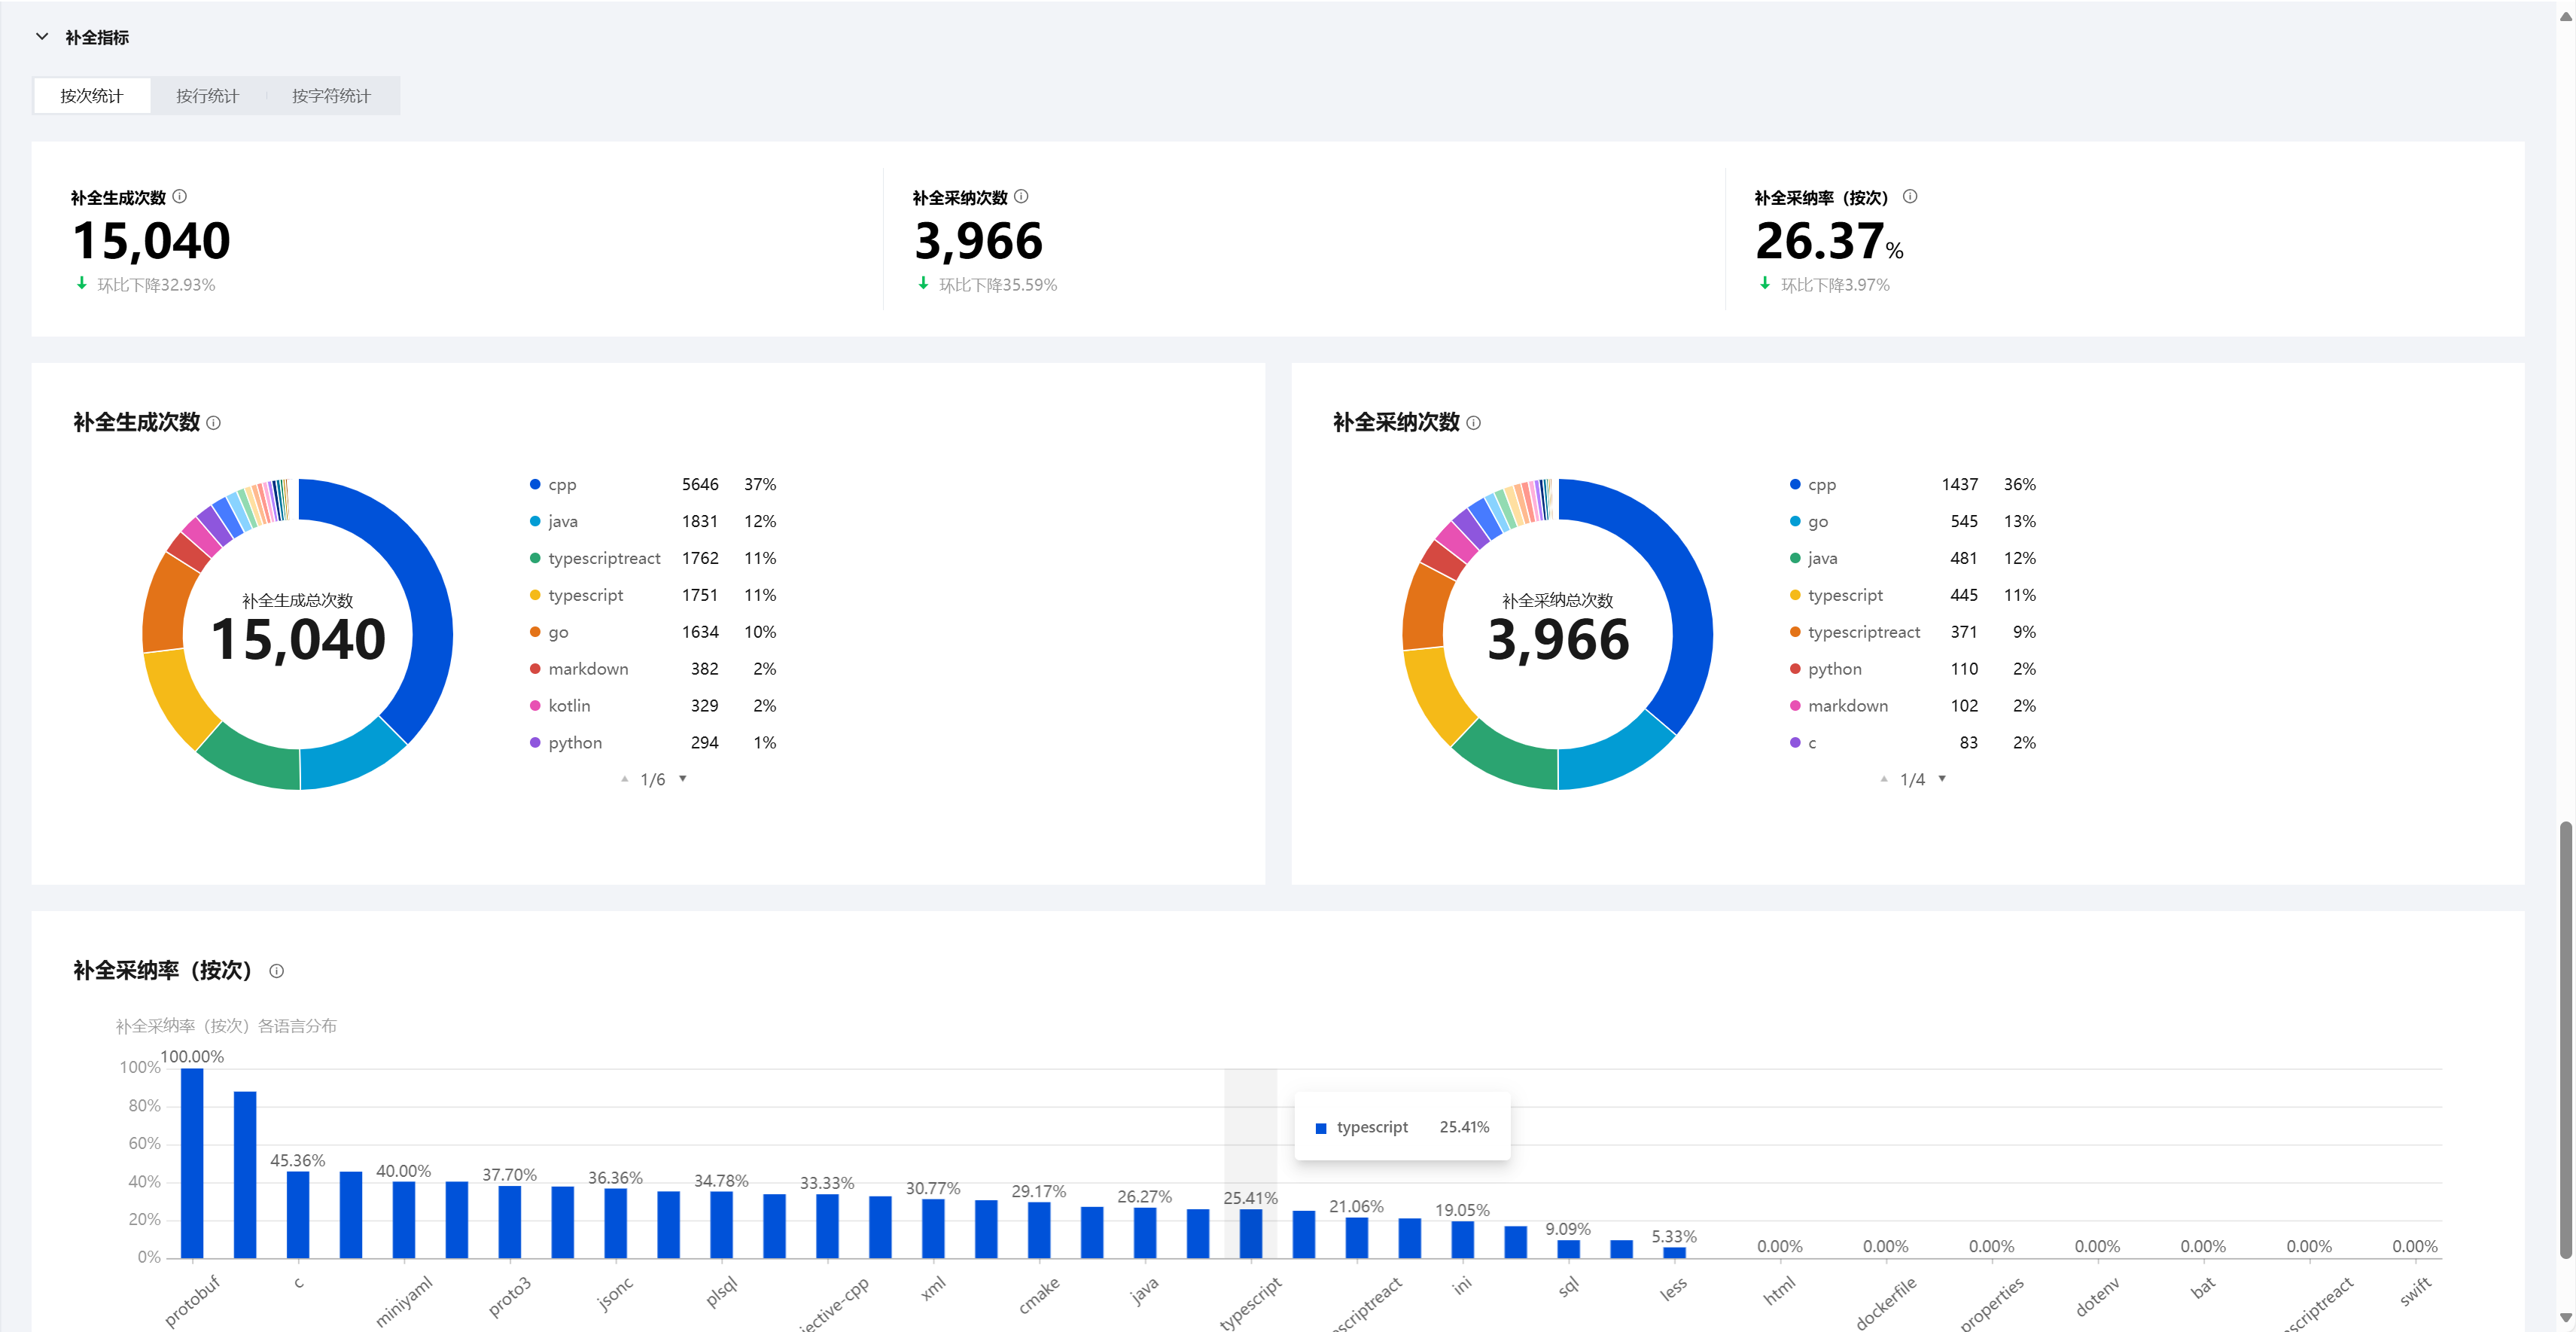
作用这两类指标直接关联企业最关心的提效成果,也是投产比测算的依据。
操作补全指标分为按次统计、按行统计和按字符统计三种口径,每种口径下都包含生成与采纳两类指标,且支持按语言展示与分析;代码生成指标分为按行统计和按字符统计两种口径,支持按语言、代码生成方式、客户端名称、客户端版本或插件版本展示。趋势视图中各指标与指标视图一一对应,例如可查看本月各 IDE 活跃数量的趋势线,或各语言下的指标趋势线。
注意代码生成率按行为 20% 代表统计时间段内每 100 行代码中有 20 行由代码助手生成;按字符为 20% 代表每生成 100 个字符中有 20 个来自代码助手。两种口径结论可能不同,汇报时务必标注清楚。
- 补全生成次/行/字符数:触发补全的总量,只要触发就计入
- 补全采纳次/行/字符数:采纳补全内容的总量,需用户执行采纳操作(例如 Tab)才计入
- 补全采纳率(按次):补全采纳次数 ÷ 补全次数,看单次触发的转化
- 补全采纳率(按行):补全采纳行数 ÷ 补全行数,适合按代码量衡量
- 补全采纳率(按字符):补全采纳字符数 ÷ 补全字符数,粒度最细也最敏感
- AI 生成代码字符数:由 AI 生成的代码量,生成方式包括代码补全、Craft、Ask(插入代码等操作)、Inline-Chat(内联对话)
- 总新增代码字符数:总计新增的代码,包括用户手动编写的代码和 AI 生成的代码
- 代码生成率(按行):AI 生成代码行数 ÷ 总新增代码行数,是面向管理者最直观的指标
- 代码生成率(按字符):AI 生成代码字符数 ÷ 总新增代码字符数,适合跨语言横向比较
作用固定统计周期才能让数据可比,导出则便于做二次分析与汇报。
操作使用看板提供的统计时间维度筛选功能,锁定本周期范围后查看各项指标,再使用数据导出功能把各项指标导出。
注意导出的空值多出现在对话次数、补全采纳次数、补全采纳率等指标中,原因通常是用户触发了补全但未采纳,或统计周期内从未触发过对话。
作用整体看板适合汇报,细节评估与具体分析必须落到人和部门。
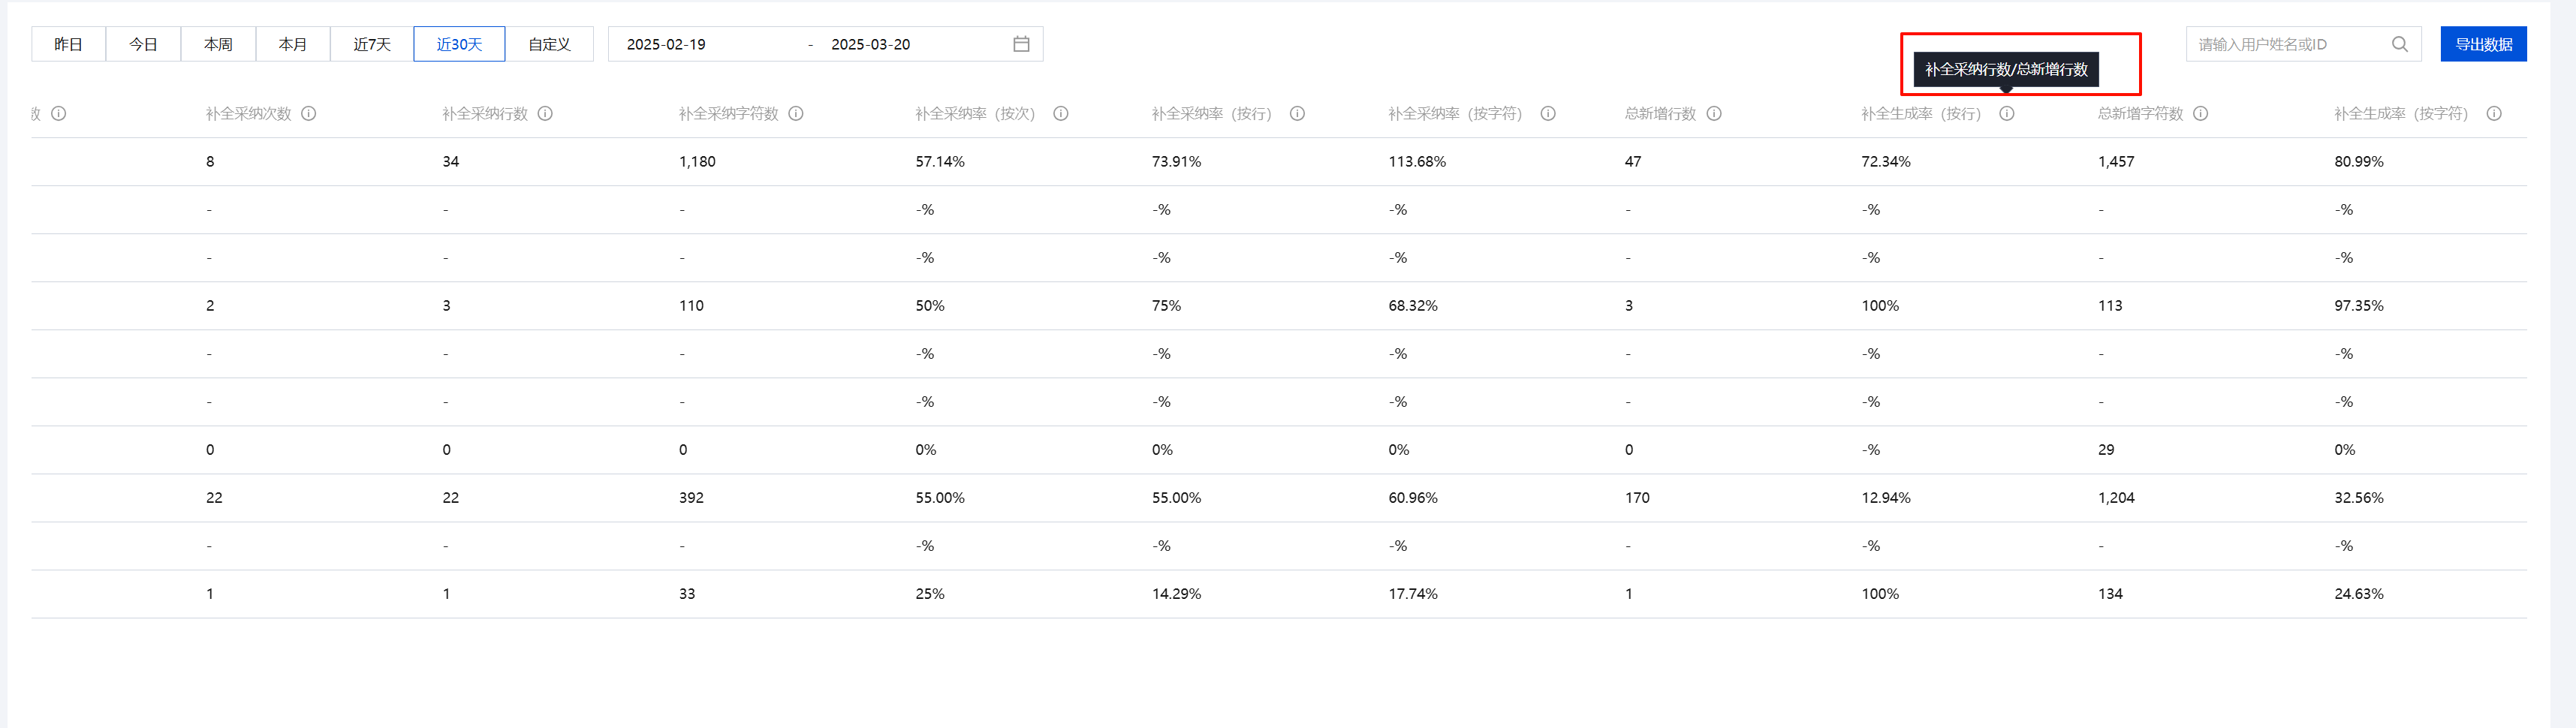
操作进入 数据统计 > 明细数据 > 成员明细,可查看全部明细指标,支持按用户 ID 筛选并一键导出为 Excel。若要看组织维度,进入 数据统计 > 明细数据 > 部门明细,指标与成员明细一致,支持按部门名称筛选或搜索部门 ID,同样支持导出为 Excel。
注意两个明细页都支持筛选统计时间维度;把明细与看板对账时,请确保时间范围一致,否则结论会互相打架。
- 对话类:对话次数、对话使用的指令次数、对话引用的上下文次数、对话使用的智能体次数、对话使用的知识库次数、对话后操作次数
- 补全类(按次):补全生成次数、补全采纳次数、补全采纳率(按次)
- 补全类(按行):补全生成行数、补全采纳行数、补全采纳率(按行)
- 补全类(按字符):补全生成字符数、补全采纳字符数、补全采纳率(按字符)
- 代码产出类:AI 生成代码行数、总新增代码行数、代码生成率(按行),以及对应的按字符三项
- 导出能力:两个页面都支持一键导出数据为 Excel 文件,可直接用于二次分析

作用大部分「数据异常」其实是同步延迟或统计口径问题,先排除这两类再深入排查。
操作若发现数据显示异常,先等待约 15 分钟再确认,因为研效度量数据同步需要 15 分钟。同时回顾统计口径:总新增行数或字符数包含手动键入与补全采纳,复制或导入超过 5 行的代码不计入;新增代码计入统计而删除不回退;补全生成的注释及其采纳也计入指标。
注意例如新增 10 行后又删除,新增行数仍记为 10 行;这类口径差异会让数据与代码仓库的实际净增量不一致,属正常现象。
- 总新增行数或字符数:包括用户手动键入与补全采纳,复制或导入的代码需限制在 5 行以内,超过 5 行属于大幅度键入,不计入统计
- 新增与删除:新增的代码计入统计,删除的不回退,例如新增 10 行后又删除,新增行数仍为 10 行
- 补全次数:用户只要触发了代码补全就计入,不管有没有执行采纳或拒绝操作,补全行数和补全字符数同理
- 生成与采纳的区别:后者需要用户执行采纳操作(例如 Tab)才计入,前者不受后续操作影响
- 注释:补全生成的注释及其采纳,均计入指标的统计内
统计口径补充说明
- 研效度量数据同步需要 15 分钟,若出现数据显示异常,可等待 15 分钟同步时间后再进行确认。
- 用户数据导出中存在为空内容,主要出现在对话次数、补全采纳次数、补全采纳率等指标中:统计周期内用户触发了补全但未执行采纳操作,或从未触发过对话,都会导致这些指标计算为空。
- 复制或导入超过 5 行的代码属于大幅度键入,不计入总新增;用代码生成率做投产比测算时,这类差异会让不同团队的口径不一致。
- 活跃情况中可以直接看到每种 IDE 的活跃数量占比,是判断工具推广是否覆盖到各类 IDE 的第一手依据。
汇报与诊断练习
```markdown
我要向团队解释「代码生成率」这个指标,请帮我写一份口径说明。
必须准确包含的事实(不要增删):
- 代码生成率(按行)=(AI 生成代码行数 / 总新增代码行数)× 100%;
- 代码生成率(按字符)=(AI 生成代码字符数 / 总新增代码字符数)× 100%;
- 举例:按行为 20% 代表统计时间段内每 100 行代码中有 20 行由代码助手生成;按字符为 20% 代表每生成 100 个字符中有 20 个字符来自代码助手;
- AI 生成代码的生成方式包括代码补全、Craft、Ask(插入代码等操作)、Inline-Chat(内联对话);
- 总新增代码包括用户手动编写的代码和 AI 生成的代码;
- 总新增行数或字符数包括手动键入与补全采纳,复制或导入的代码需限制在 5 行以内,超过 5 行属于大幅度键入不计入统计;
- 新增的代码计入统计,删除的不回退,例如新增 10 行后又删除,新增行数仍为 10 行;
- 补全次数只要触发即计入,不管是否采纳;补全采纳次数需用户执行采纳操作(例如 Tab)才计入;补全生成的注释及采纳也计入统计。
请输出:1)一段面向非技术管理者的白话解释(不超过 200 字);2)一张「常见误解 vs 实际口径」对照表,至少 5 行;3)一段使用该指标做投产比测算时的注意事项(不超过 150 字)。
```得到一段白话解释、一张误解对照表和一段注意事项,所有计算口径与边界条件与给定信息完全一致。
```markdown
我要做一份季度研效汇报,请帮我设计取数清单。
可查看的指标(请只基于这些设计,不要新增指标):
- 活跃情况:活跃用户数量、补全活跃用户数量、对话活跃用户数量,可看各 IDE 活跃占比;
- 对话指标:对话次数、对话使用指令次数、对话引用上下文次数、对话使用智能体次数、对话使用知识库次数、对话中代码段操作次数;
- 补全指标:按次/按行/按字符三种口径下的补全生成数、补全采纳数与补全采纳率,支持按语言展示;
- 代码生成指标:按行/按字符两种口径,支持按语言、代码生成方式、客户端名称、客户端版本或插件版本展示;
- 成员明细与部门明细:指标与看板一致,支持按用户 ID 或部门名称/部门 ID 筛选,支持一键导出 Excel;
- 看板支持按统计时间维度筛选与数据导出。
已知约束:研效度量数据同步需要 15 分钟;导出中空值多出现在对话次数、补全采纳次数、补全采纳率,原因是用户触发补全未采纳或从未触发对话。
请输出:1)一张取数清单表(指标 / 从哪个页面取 / 用什么维度筛选 / 汇报中用来说明什么 / 需要注意的坑);2)一段汇报主线的建议顺序(不超过 200 字);3)一段「数据为空时如何解释」的话术。
```得到一张取数清单表、汇报主线建议和空值解释话术,指标来源页面标注准确,且提示了 15 分钟同步延迟。
```markdown
我拿到了本季度的研效度量数据,需要诊断提效瓶颈。
已知指标口径(请严格按此推断,不要编造新指标):
- 活跃用户数量:使用过补全或对话的用户数量;补全活跃用户数量:使用过补全的用户数量;对话活跃用户数量:使用过对话的用户数量;
- 对话次数:使用对话的总次数;对话使用指令次数:对话时使用的斜杠命令次数;对话引用上下文次数:对话时通过 @ 引用上下文的次数,类型包括文件、文件夹、Diff 文件、变更、知识库、终端命令等;对话使用智能体次数:对话时使用的智能体次数,例如 @workspace;对话使用知识库次数:对话时使用的知识库次数;对话中代码段操作次数:对对话中返回的代码段执行的操作次数;
- 补全采纳率(按次/按行/按字符):采纳数除以生成数。
我的数据特征:活跃用户数不低,但对话引用上下文次数和对话使用知识库次数接近 0,补全采纳率(按次)偏低,代码生成率(按行)中等。
请输出:1)一张「现象—可能原因—验证方法—改进动作」四列诊断表,至少 4 行;2)一段优先行动建议(不超过 150 字),说明先做哪一件事及理由;3)一份改进后用什么指标验证效果的方案(不超过 150 字)。
```得到一张结构化诊断表、优先行动建议和效果验证方案,推断严格基于给定指标含义,未编造新指标。
本文基于官方文档再创作,具体以官方文档站实际展示为准。