模型配置全解:三档模式、自定义模型与本地部署
本篇涵盖的知识重点
- 快速、均衡、极致三档模型模式各自适合的任务复杂度
- 思考强度决定模型作答前的推理投入,可选档位取决于模型本身
- 上下文窗口默认 200K,调大不会让模型变聪明只会增加积分消耗
- Max 模式关闭时会自动压缩上下文,开启则全程不压缩
- 内置模型十余款,覆盖图片输入、思考模式与推理能力
- 自定义模型配置仅保存在本地 models.json,API Key 不上传云端
- Ollama 本地部署可满足数据不出本机、零成本试用与离线可用
配置路径一览
三档模式、内置模型与自定义接入详解
作用选对档位等于在速度和质量之间一次到位,不用每次都靠重试补质量。
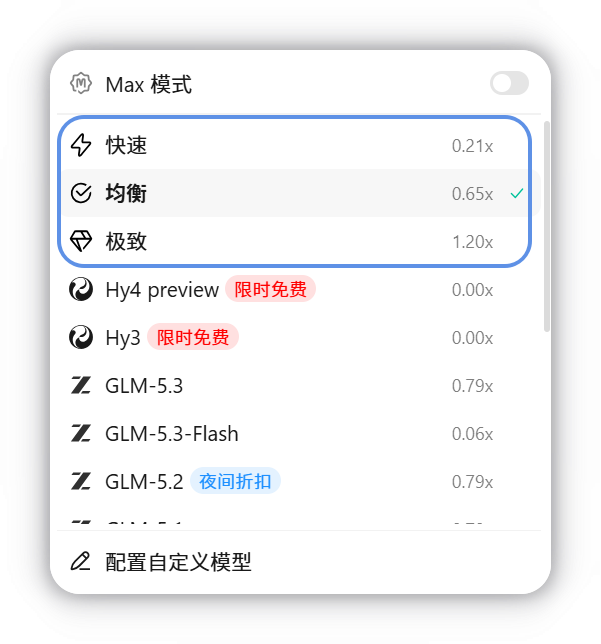
操作在模型选择器中按任务复杂度选档:简单明确的任务用快速模式,绝大多数任务用均衡模式,跨模块、多步骤的复杂任务用极致模式。
注意企业版用户注意:企业管理员在后台禁用的模型,会在客户端模型选择器中同步隐藏或置灰(含 auto),无法选择,此时需联系企业管理员确认启用状态。
- 快速模式:适合日常问答、格式转换、小段代码修改、文案润色这类简单明确的任务,响应最快、消耗最低
- 均衡模式:覆盖写文档、分析数据、多文件代码改动等绝大多数任务,效果和速度兼顾,不确定选哪档时用它
- 极致模式:面向跨模块重构、多步骤推理、需要反复验证的分析,响应稍慢、消耗更高,但复杂任务下结果更稳定
作用逻辑链长、容易出错的任务多给点推理预算,简单问答则没必要等它反复自检。
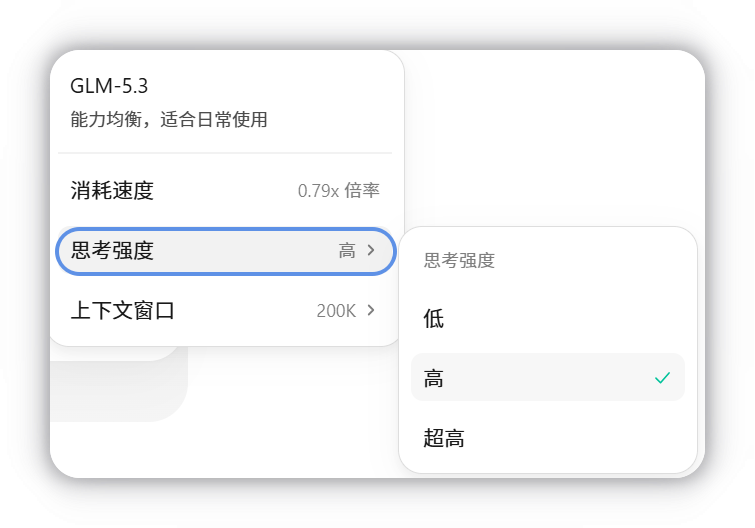
操作思考强度对应模型在给出答案前的推理投入,可选等级取决于该模型自身支持的档位。强度越高,模型做更多分析和自我检查;强度越低,倾向直接作答、响应更快。在模型配置的强度选项里直接选档即可。
注意系统已默认选择适合绝大多数任务的强度,一般无需单独调整;只有逻辑链条明显偏长或结果反复出错时才值得上调。
作用上下文直接决定每轮对话的 token 量,是积分消耗最容易被忽略的杠杆。
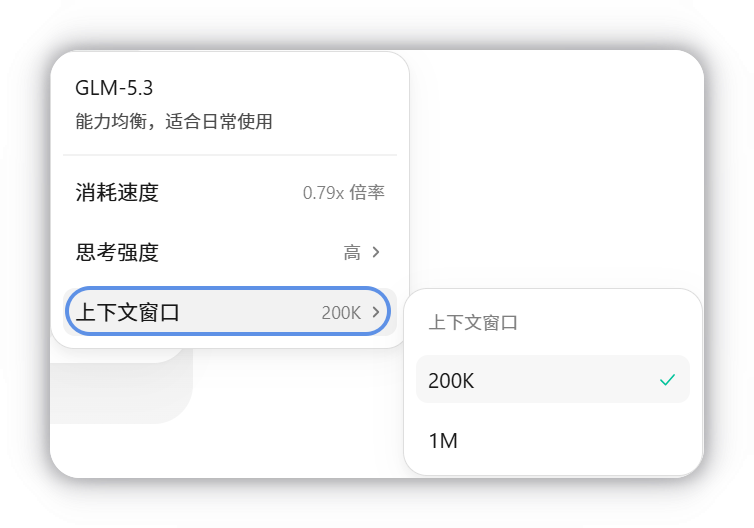
操作上下文窗口默认 200K,适用于绝大多数任务。每一轮对话都会把当前上下文完整发送给模型,因此窗口越大,单轮消耗的积分越多。如确需调整,在模型配置的上下文窗口选项中设置。
注意窗口不是越大越好——开到 1M 不会让模型变聪明,只会让每轮消耗成倍增加;只有处理超长文档或需要模型完整记住大量历史内容时才调大。
作用长对话里是否压缩上下文,是在「细节不丢」和「积分省着用」之间做取舍。
操作关闭 Max 模式时,系统会在合适的时机自动触发上下文压缩,减少长对话中的重复传输、降低积分消耗;开启 Max 模式则全程完整保留上下文、不做压缩,细节一点不丢,代价是长对话积分消耗明显更快。在模型配置中切换该开关即可。
注意建议保持关闭,仅在确实需要超长上下文时再开启,用完记得关回去。
作用内置模型已有十几款,先看清楚各自的长项,再决定要不要额外接第三方,能省掉不少试错。
操作在模型选择器中查看内置模型列表。带图片输入的模型能直接读图,带思考模式的模型适合长推理链,标为推理模型的则在日常任务上更均衡;需要 1M 上下文时优先看标注支持 1M 的那几款。
注意不同模型支持的档位与能力并不一致,比如并不是每款都支持图片输入;企业版下被管理员禁用的模型会被隐藏或置灰。
- Hy4 preview:混元新一代模型,支持图片输入与思考模式,适合需要边看图边推理的任务
- Hy3:混元思考模型,推理能力增强,同样支持图片输入与思考模式
- GLM-5.3:GLM 新一代模型,支持 1M 上下文窗口,超长材料可以一次读完
- GLM-5.3-Flash:GLM 新一代模型的快速版本,支持思考模式,追求响应速度时优先
- GLM-5.2:1M 上下文、擅长长程任务,适合跨大量文件的持续工作
- GLM-5.1:能力均衡、适合日常使用,属于推理模型
- GLM-5v-Turbo:原生多模态模型,图片输入与推理能力兼备
- MiniMax-M3:原生多模态,擅长代码与智能体任务
- MiniMax-m2.7:能力均衡、适合日常使用,性价比高
- Kimi-K3:擅长复杂的长程自主任务,前端开发能力突出,在知识工作与科研推理上同样出色
- Kimi-K2.7-Code:多模态模型,面向编程场景优化
- Kimi-K2.6:多模态模型,适合日常任务
- Deepseek-V4-Flash:DeepSeek 旗舰模型,支持 1M 上下文窗口,速度优先
- Deepseek-V4-Pro:DeepSeek 旗舰模型,支持 1M 上下文窗口
作用想用特定厂商的模型、或把已购套餐的模型接进来,都要走自定义模型这一条路。
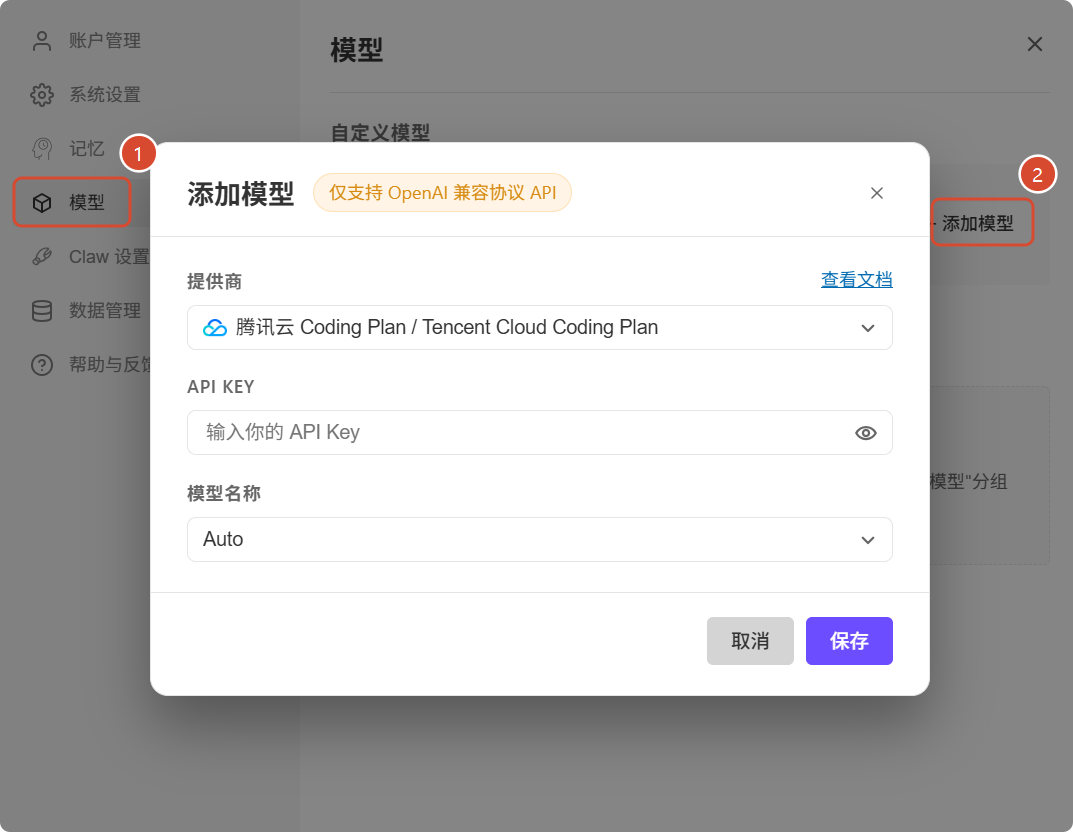
操作在设置页的模型中可以通过图形界面管理自定义模型,无需操作配置文件:已配置的模型以列表展示,每条显示模型名称与供应商图标,添加、编辑、删除都通过弹窗完成。配置保存后自动持久化;选择标准供应商时,工具调用、图片输入等能力标记会自动写入。对话界面的模型选择器会展示自定义模型分组,并支持快捷跳转到配置界面编辑。
注意配置参数(含 API Key)仅保存在本地 workbuddy/models.json 中,不上传云端;已通过 ~/.codebuddy/models.json 配置的模型在界面升级后仍可正常使用,并可通过 UI 查看、编辑或删除。API Key 请勿分享给他人,不再使用时建议在 models.json 中清理。
作用不同来源的模型走不同入口,选对了可以少填很多字段、少踩很多坑。
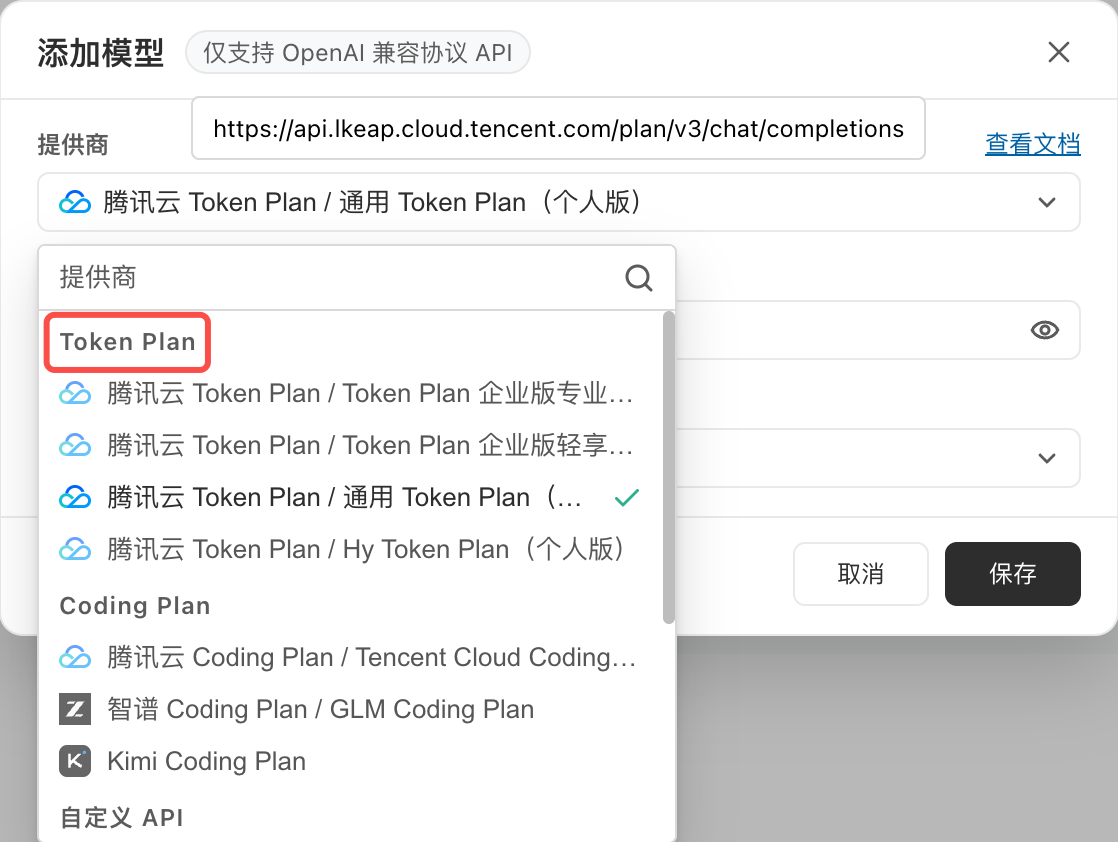
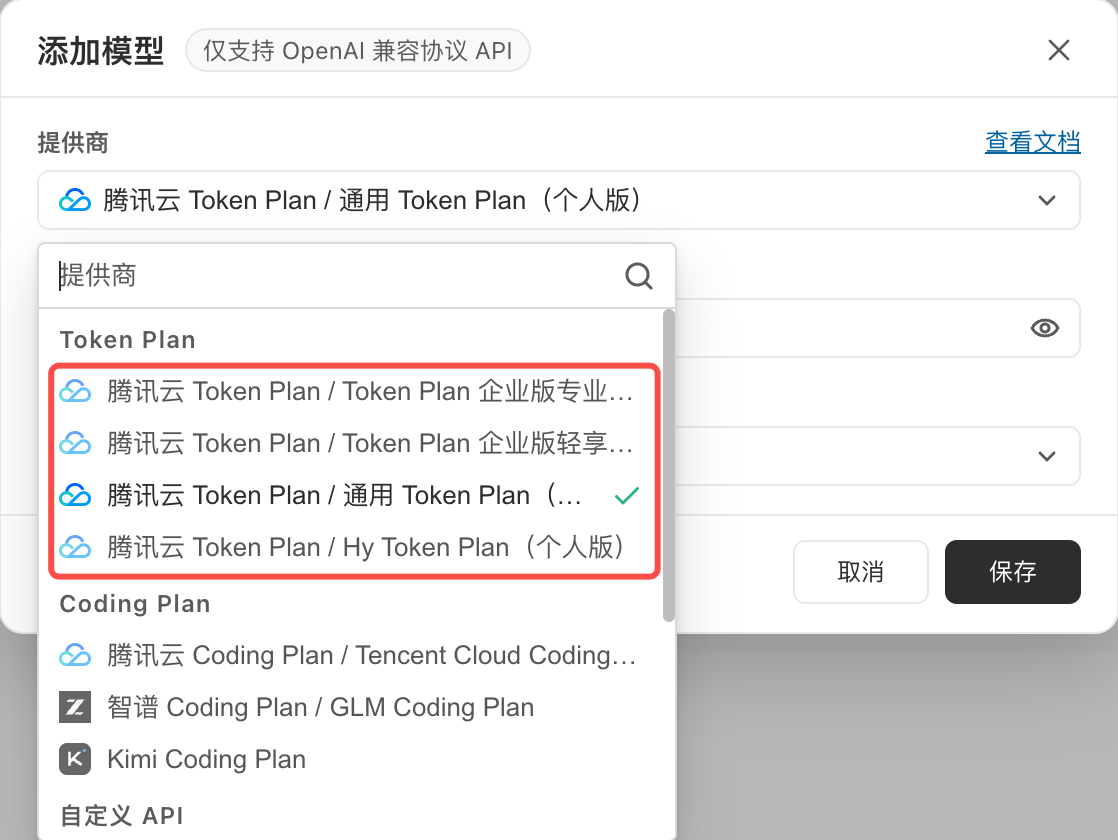
操作提供商接入:从列表中选择提供商或选择自定义 API,URL、模型列表与能力标记会自动填充,只需补全 API Key。已购买腾讯云 Token Plan 套餐的,按「选供应商 → 填 API Key → 选模型」三步走。本地部署用 Ollama:安装后一行命令即可拉取并运行开源模型。
注意自定义模型产生的全部费用(Token、订阅等)由你向第三方支付,建议密切关注第三方账户费用;接入前请确认来源合法并阅读该服务方的协议与隐私政策。
- 第一步:在添加模型页面按已购套餐类型选择对应供应商,可选 Token Plan 企业版专业套餐、企业版轻享套餐、通用 Token Plan(个人版)或 Hy Token Plan(个人版)
- 第二步:填入套餐对应的 API Key,不同套餐的 API Key 按各自的官方获取指引取得
- 第三步:选择套餐支持的模型,不同套餐的可用模型不一样
- 提供商接入:从提供商列表选择或选自定义 API,URL、模型列表与能力标记自动填充,全程无需手动修改配置文件
- Coding Plan:为 AI Coding 场景推出的专属订阅套餐,支持接入腾讯云 Coding Plan、智谱 Coding Plan 和 Kimi Coding Plan
- 本地部署 Ollama:安装后一行命令拉取并运行开源模型,启动后默认监听 11434 端口,并提供兼容 OpenAI 协议的接口供对接
- 自定义 / Custom:模型服务不在列表中时,手动填写 URL、API Key 与模型名接入
- 数据隐私 / 内网合规:代码与对话内容不出本机,适合金融、政企、敏感项目场景
- 零成本试用:不用消耗 Token、不用付费 API Key,把硬件当算力
- 离线可用:飞机上、内网开发机、没网的环境也能用
作用经过网关或代理层封装的模型服务,接口路径往往不是标准的,这时需要显式告诉它别自动补全。
操作当模型服务使用非标准 URL 路径时,可在高级配置中开启自定义协议开关。关闭状态下系统使用标准 /chat/completions 路径并自动校验补全;开启后直接按填写的 URL 发起请求,跳过路径校验与自动补全逻辑。
注意自定义协议仅在确实经过网关或代理层封装时才需要开启;一旦开启,填写的 URL 将不再被校验,写错就得自己排查。
- 关闭(默认):使用标准 /chat/completions 路径,自动校验并补全接口地址,绝大多数服务用这个
- 开启:直接使用你填写的接口地址发起请求,跳过路径校验与自动补全逻辑
接入风险与费用提醒
- WorkBuddy 仅作为通信链路:把你的输入直接转发至配置的第三方模型,输出由该模型直接返回;除完成请求、必要传输、安全审计、故障排查、依法留存所必需外,不读取、不存储相关内容。
- 配置参数(含 API Key)仅本地保存,WorkBuddy 不向云端上传;API Key 关联你的账户与套餐额度,请勿分享给他人,泄露可能导致配额被盗用、产生额外费用或数据安全风险。
- 自定义模型产生的全部费用(Token、订阅等)由你向第三方支付,使用过程中可能持续触发模型调用,建议密切关注第三方账户费用。
- 自定义模型由第三方独立运营,其可用性、稳定性、安全性、合规性与生成结果请关注该第三方的服务状态与公告。
- 企业管理员在后台禁用的模型,会在客户端模型选择器中同步隐藏或置灰(含 auto),无法选择,需联系企业管理员确认启用状态。
- 若接入存在违法违规风险,依据用户协议 §8.3.2,WorkBuddy 可能中止、限制或禁止该模型的接入;请确保模型来源合法。
上手挑战
```markdown
我手上有 5 类日常任务:1)把一段中文文案润色得更简洁;2)读取一个 Excel 做月度销售统计并写结论;3)重构一个跨 6 个模块的前端项目目录;4)识别一批截图里的数据并录入表格;5)做一份需要反复核对数据的行业分析。请帮我为每一类推荐 WorkBuddy 的模型档位(快速/均衡/极致)与思考强度建议,说明理由,并指出哪几类其实可以用更低的档位省钱。用文本条目输出,不要臆造 WorkBuddy 未提供的档位名称。
```得到一份任务与档位的对照说明及省钱建议;照它设置后,日常任务不需要每次都开最高档,复杂任务也不会因档位太低反复返工。
```markdown
我在考虑把 WorkBuddy 的上下文窗口从默认 200K 调到更大。请帮我算一笔账:假设一轮对话平均占用 8 万 token、每天对话 30 轮,请分别估算 200K 与 1M 两档窗口下,每轮大致的上下文传输量差异与月度的相对消耗倍数,并说明在哪些真实场景下这种调大是值得的、哪些场景下纯属浪费。要求给出计算过程与假设前提,结论控制在 5 条以内。
```得到一份带计算过程的消耗估算与 5 条结论;能据此判断自己是否真的需要调大窗口,而不是凭感觉开到最大。
```markdown
我在考虑用 Ollama 在本地跑开源模型并接入 WorkBuddy,替代一部分云端模型调用。请帮我做一次适用性评估,从以下维度给出判断与依据:数据隐私与内网合规、硬件成本与性能预期、离线可用性、维护复杂度,以及与云端模型的体验差距。请特别说明哪些场景(如金融、政企、敏感项目)本地部署几乎是必需的,哪些场景下其实不划算。输出为 Markdown 报告,含一个决策清单。
```得到一份分维度评估报告和一个可直接打勾的决策清单;照清单判断后即可决定要不要投入硬件做本地部署。
```markdown
我们已经给团队的 WorkBuddy 接入了多个第三方自定义模型,担心 API Key 泄露与费用失控。请帮我制定一份《自定义模型接入管理规范》,需包含:API Key 的保管与分发原则、禁止的操作(如在共享环境填写、随意外发配置文件)、不再使用时的清理步骤(涉及本地 models.json)、费用监控的做法与预警阈值建议,以及接入新模型前必须完成的合规检查项(含确认供应商可信、阅读服务方协议与隐私政策)。输出为 Markdown,条款要具体可执行。
```得到一份可直接落地的管理规范;团队按它执行后,Key 泄露面收敛,第三方账单也能被及时发现异常。
本文基于官方文档再创作,具体以官方文档站实际展示为准。