入门篇 · 移动端 · 功能说明
移动端怎么选模型:能力标签与积分消耗看明白
本篇涵盖的知识重点
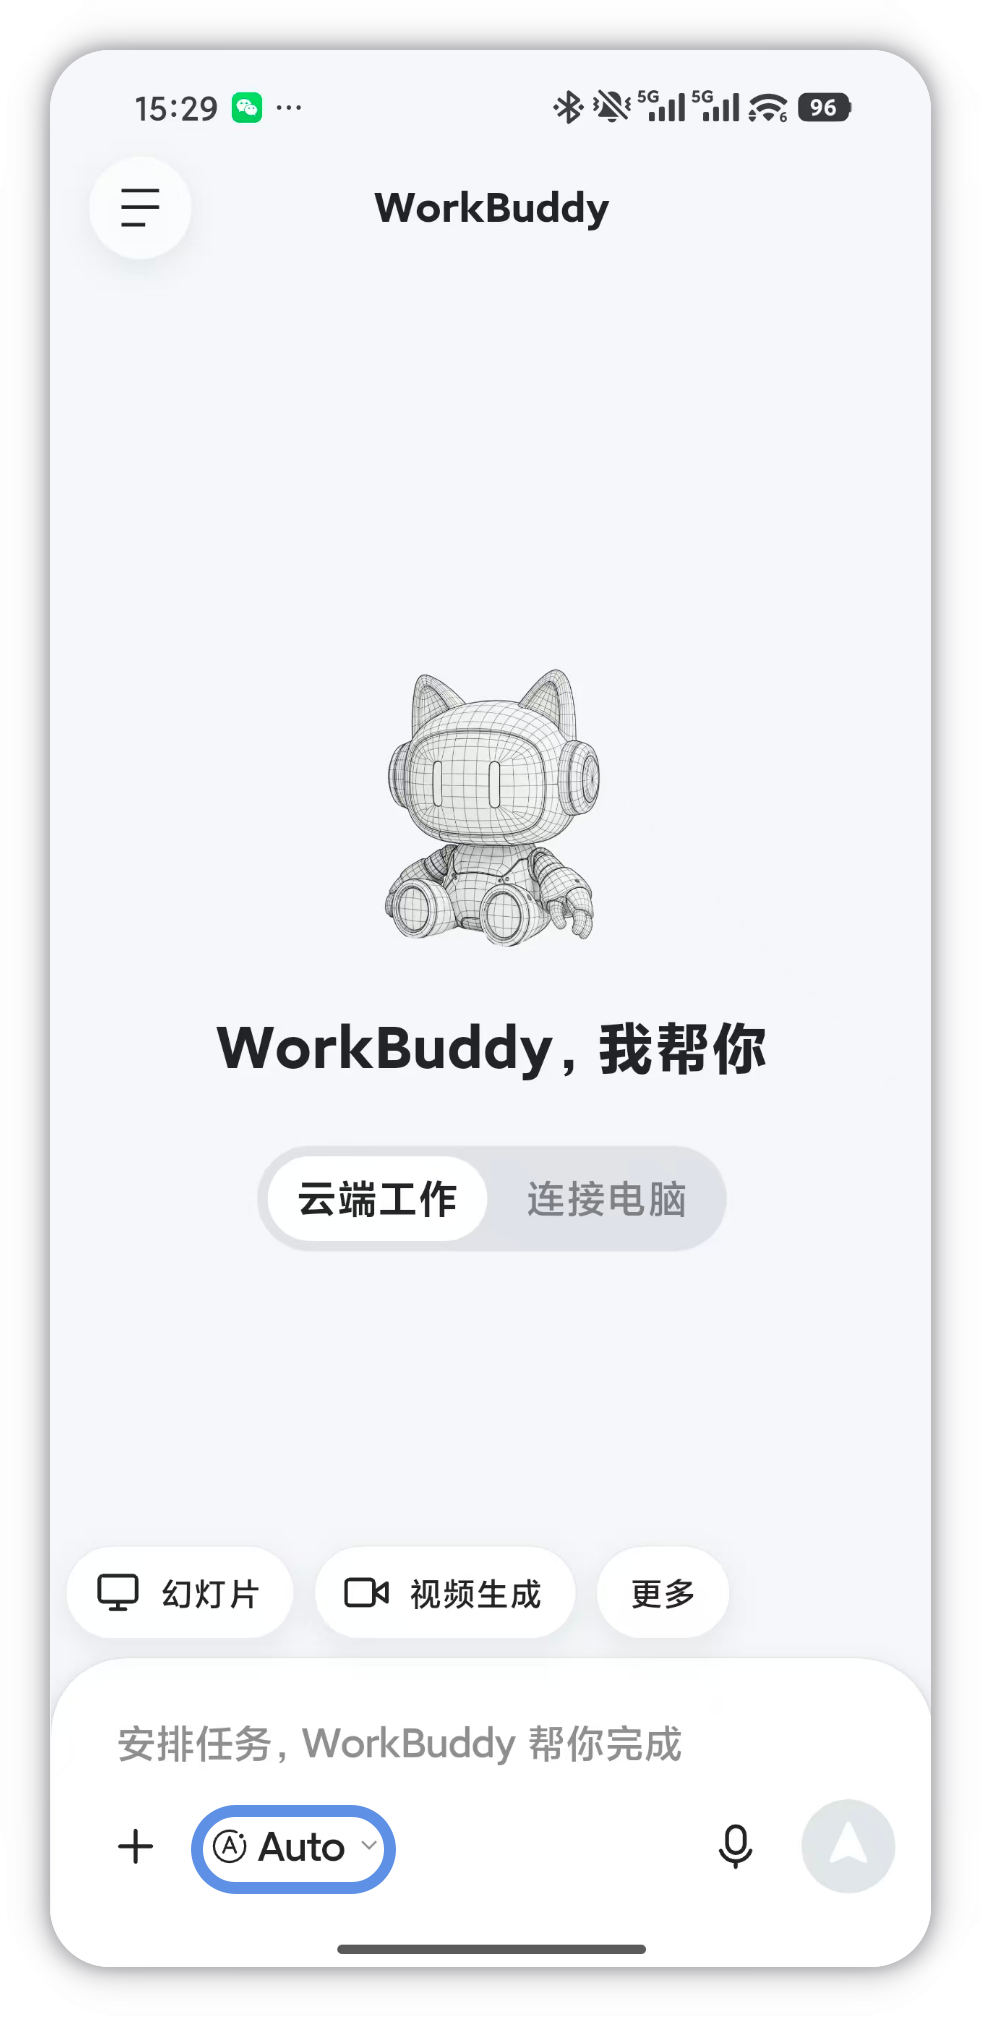
- 模型入口在输入栏,点模型名称(如「Auto ▾」)弹出选择面板
- Auto 是默认的智能自动选择,拿不准就用它
- 带「视觉」标签的模型才支持图片理解,拍照和截图场景必须选
- 「推理」标签代表支持逻辑推理、任务规划与多步骤执行
- GLM-5.2 拥有 1M 上下文,擅长长程任务
- 面向编程的可选 Kimi-K2.7-Code,日常高性价比可选 MiniMax-m2.7
- 每个模型名称下方标注积分倍率,如 x0.80、x1.00,数字越低消耗越少
- 日常简单任务用性价比模型、图片任务再切视觉模型,是省钱主线
选型路径一览
共 5 步,按编号顺序阅读
模型清单与标签释义
1打开模型选择面板
作用换模型是每次提问前都能做的一步,入口找熟了才能随任务切换。
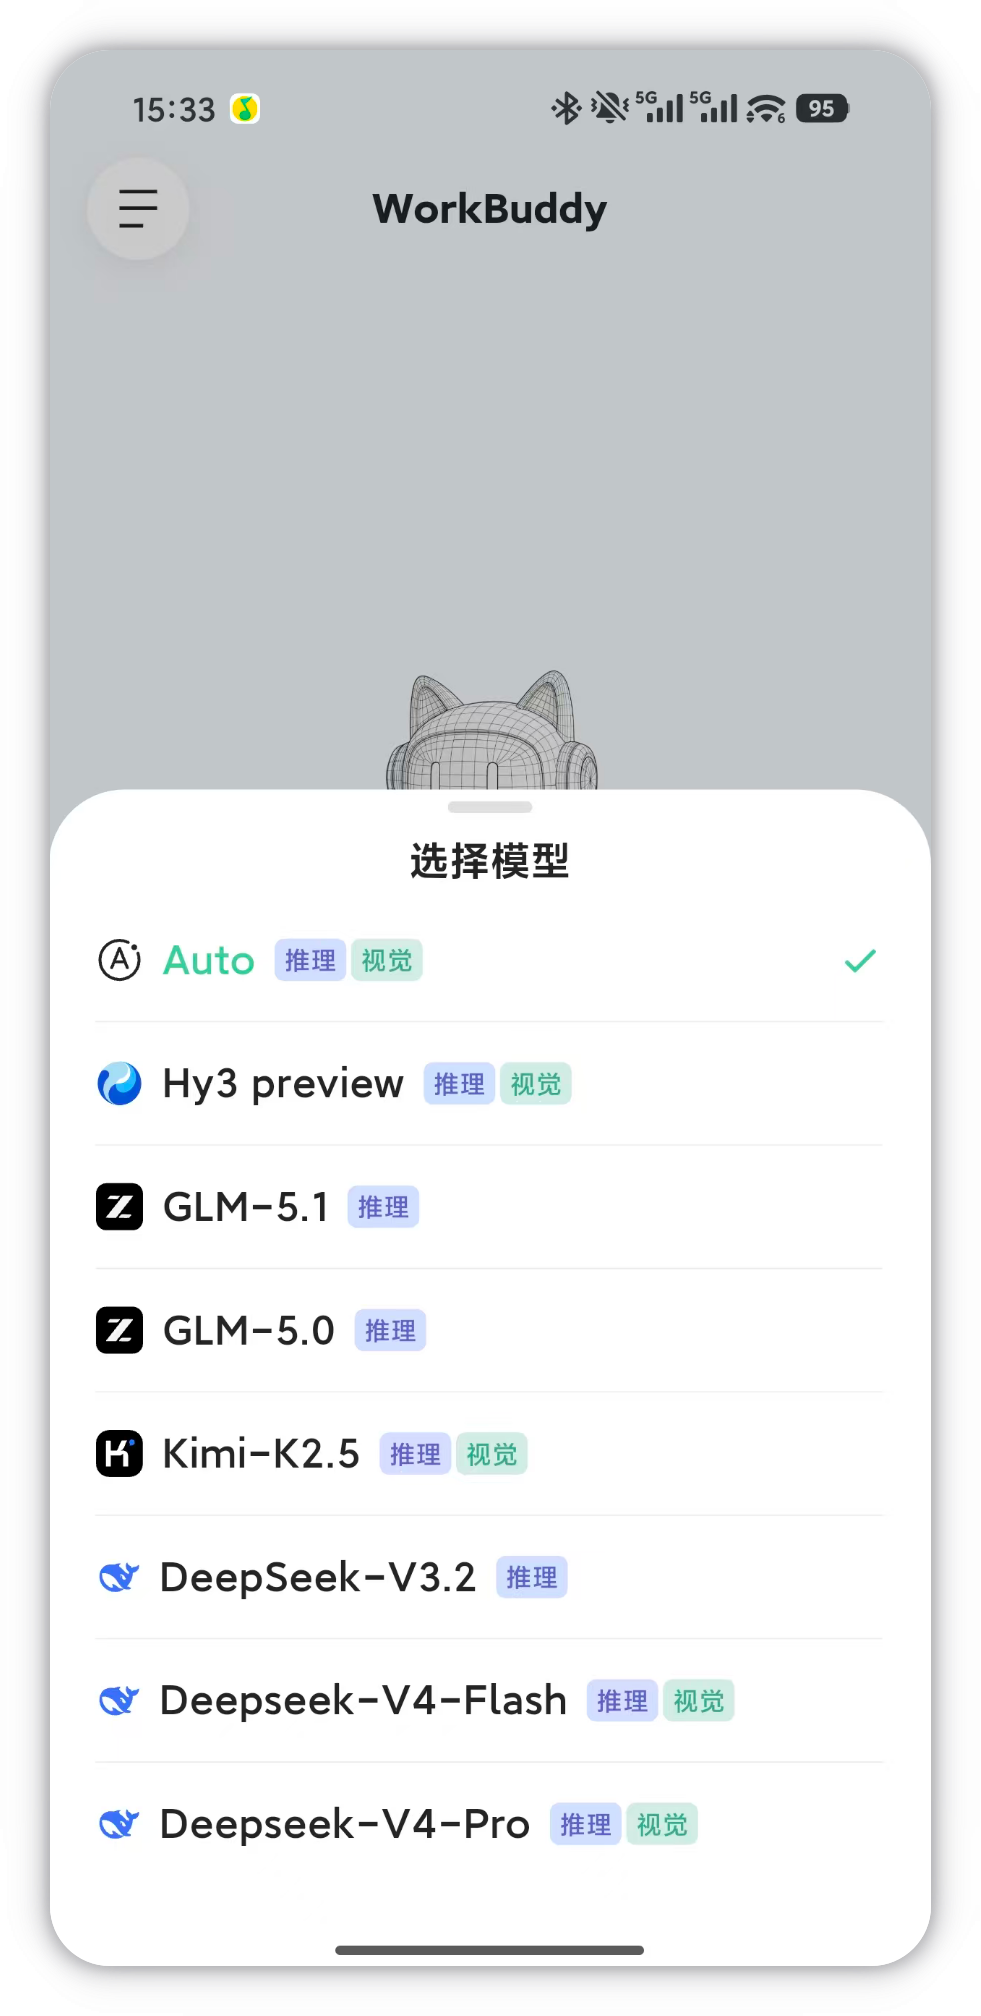
操作在输入栏中点击当前显示的模型名称(例如「Auto ▾」),即可弹出模型选择面板,面板里列出所有可用模型及其能力标签、推荐场景与积分倍率。
注意模型切换只影响之后的对话,已经生成的回答不会因为换模型而重算。
2按推荐场景挑模型
作用不同模型的强项差异很大,对着场景清单选比对着名字猜靠谱得多。
操作在面板里对照每个模型的推荐场景做选择,选中即切换。
注意具体可用名单以你面板里实际展示为准,版本更新可能会增删模型。
可选模型与推荐场景
- Auto(推理 + 视觉):智能自动选择,为默认项,拿不准时直接用它。
- Hy3(推理 + 视觉):高性能推理与视觉理解,复杂提问又带图时优先考虑。
- GLM-5.2(推理 + 视觉):1M 上下文,擅长长程任务,超长材料交给它。
- GLM-5.1(推理):多步骤复杂任务、深度推理,纯文字推演场景用它。
- GLM-5v-Turbo(推理 + 视觉):原生多模态模型,图文混合的常规任务合适。
- MiniMax-M3(推理 + 视觉):原生多模态,擅长代码、智能体任务。
- MiniMax-m2.7(推理 + 视觉):能力均衡,适合日常使用,性价比高。
- Kimi-K3(推理 + 视觉):擅长处理复杂的长程自主任务,前端开发能力突出,同时在知识工作与科研推理上表现出色。
- Kimi-K2.7-Code(推理 + 视觉):多模态模型,面向编程场景优化。
- Kimi-K2.6(推理 + 视觉):多模态模型,适合日常任务。
- DeepSeek-V4-Flash(推理 + 视觉):快速响应,兼顾视觉理解,追速度时选它。
- DeepSeek-V4-Pro(推理 + 视觉):高性能推理与视觉分析,要求质量时选它。
3看懂推理与视觉标签
作用标签决定了模型能不能干这件事,是不看长说明也能快速判断的依据。
操作在面板里看每个模型挂的是「推理」还是「视觉」,按任务性质对号入座。
注意把 OCR 或图片理解类任务交给只有「推理」标签的模型(如 GLM-5.1),它会读不懂图片内容。
两类能力标签的含义
- 推理:支持逻辑推理、任务规划与多步骤执行。
- 视觉:支持图片理解,拍照、截图场景请选择此类模型。
4对照积分倍率控成本
作用同样的提问花在不同模型上的成本不一样,看懂倍率才能既省又不降级体验。
操作不同模型的积分消耗有所不同,在模型选择面板中每个模型名称下方会标注相应的积分倍率,例如 x0.80、x1.00 等,数字越低消耗越少。
注意具体倍率数值请看你打开面板时显示的数字,不要沿用别人截屏里的旧值。
5拿不准就回到默认项
作用不确定时让系统自动匹配,比对着一串名字纠结更省事也更稳。
操作如果完全不知道该选哪个,保持默认的 Auto 即可,系统会自动匹配最优模型,需要调整时再按上面的方法手动切换。
注意只有在明确知道任务需要某种能力时才手动指定,随意指定反而可能降低效果。
省钱与选型提醒
- 省钱小技巧:日常简单任务选择性价比高的推理模型,需要图片理解时再切换到带「视觉」标签的模型。
- 如果不确定选哪个,使用默认的 Auto 即可,系统会自动匹配最优模型。
- 在模型选择面板中,每个模型名称下方会标注相应的积分倍率(如 x0.80、x1.00 等),数字越低消耗越少。
选型练习
练习1:为四类任务各挑一个合适的模型
提示词(点右上角「复制」,可直接发给 WorkBuddy)
```markdown
我手头有四类任务:(1) 看一张海报图片并写出推广文案;(2) 一次性分析一份三十万字的行业调研资料;(3) 写一个包含多个文件的 Python 小工具;(4) 日常简单问答。请按照 WorkBuddy 移动端模型的能力标签(推理、视觉)和推荐场景,为每类任务各推荐一个模型并说明理由,输出成四行的 Markdown 表格。表格之后再用两句话说明:积分倍率标注在界面的什么位置,倍率数字的大小代表什么。
```
预期结果
四类任务各有一个模型推荐且理由能对应到标签或场景,并说明倍率标注位置与数字含义。
练习2:给每天二十张图片的处理排省钱方案
提示词(点右上角「复制」,可直接发给 WorkBuddy)
```markdown
我每天要处理大约二十张截图和照片,主要是识别画面内容和提取其中的文字。请给我一份 150 字以内的省成本方案,讲清三件事:这类任务为什么必须选带「视觉」标签的模型;纯文字类的日常任务可以换到哪一类更划算;完全没有把握的时候应该用哪个默认选项。不要写出任何具体的积分数值。
```
预期结果
回答点明图片任务需视觉模型、纯文字可选性价比模型、拿不准用默认 Auto,且未出现虚构倍率数值。
练习3:为长程任务挑模型并写好起始指令
提示词(点右上角「复制」,可直接发给 WorkBuddy)
```markdown
我要做一个跨多轮的长程任务:把一份很长的行业报告推进到成稿,分调研、分析、成稿三个阶段。请先给出模型选择建议,重点关注列表里上下文更长、擅长多步骤复杂任务的模型,说明理由。然后把这条需求改写成一段我能直接发送的完整指令,指令里必须写清三个阶段的分工、每个阶段的交付物,以及每阶段的验收标准。
```
预期结果
建议指向长上下文或深度推理类模型,并产出一条含三阶段划分与验收点的完整指令。
参考文档:选择模型(WorkBuddy 官方文档)
本文基于官方文档再创作,具体以官方文档站实际展示为准。
本文基于官方文档再创作,具体以官方文档站实际展示为准。